




Minderheiten und künstliche Intelligenz: Das kulturelle Erbe ins digitale Zeitalter bringen
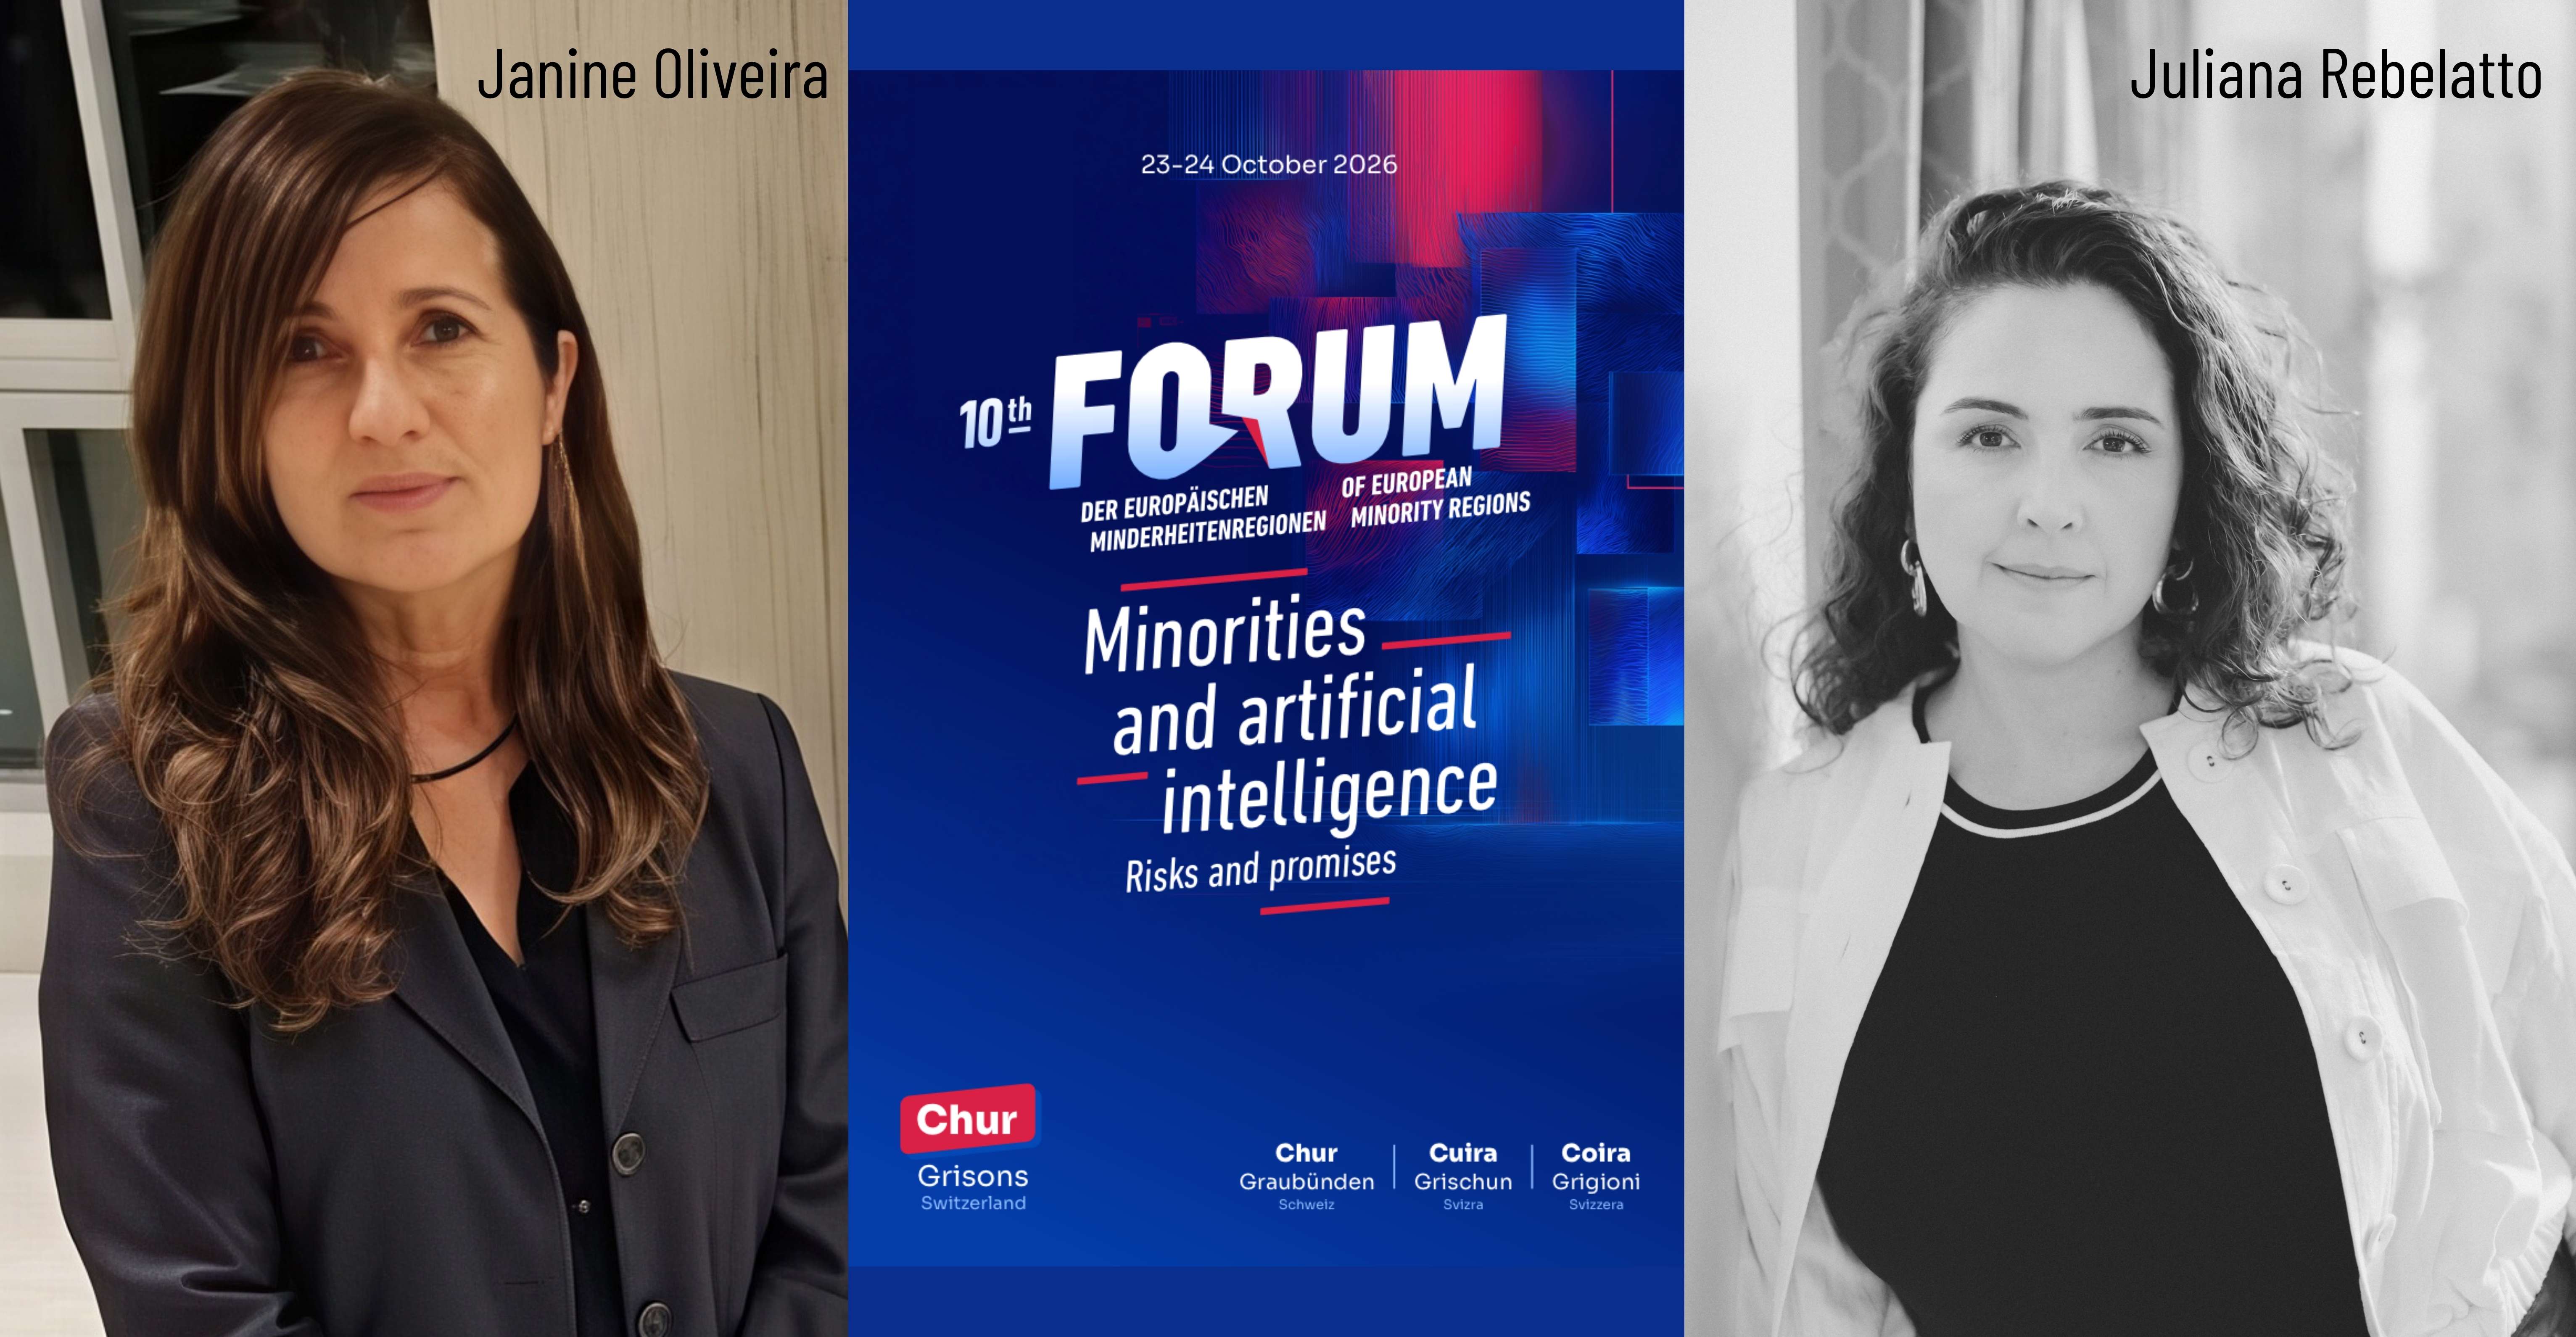
16.10.2026Die rasante Entwicklung der künstlichen Intelligenz eröffnet neue Möglichkeiten für den Erhalt von Minderheitensprachen und kulturellen Identitäten in Europa, bringt aber auch erhebliche Herausforderungen mit sich. Mit diesen Fragen beschäftigt sich das 10. Forum Europäischer Minderheitenregionen, das am 23. und 24. Oktober 2026 in Chur/Cuira/Coira in der Schweiz stattfindet. Unter dem Motto „Minderheiten und KI – Risiken und Chancen“ bringt das Forum Vertreterinnen und Vertreter aus Politik, Kultur, Wissenschaft und Minderheitenorganisationen zusammen. Gemeinsam diskutieren sie darüber, wie sich neue Technologien auf weniger verbreitete Sprachen auswirken und mit welchen Strategien sich das kulturelle Erbe von Minderheiten im digitalen Zeitalter bewahren und weiterentwickeln lässt. Die Teilnehmerinnen und Teilnehmer haben während der Veranstaltung außerdem Gelegenheit, verschiedene KI-Anwendungen und Projekte selbst auszuprobieren.
Zu den Referentinnen des diesjährigen Forums gehören Janine Oliveira und Juliana Rebelatto. Janine Oliveira ist Executive Director of Business Development bei Lenovo und leitet die ESG-Initiative für gefährdete Minderheitensprachen. Juliana Rebelatto ist bei Lenovo MBG für den Bereich Globalisierung verantwortlich und leitet ebenfalls die ESG-Initiative für gefährdete Minderheitensprachen. Gemeinsam stehen sie an der Spitze der Motorola-Initiative zur digitalen Inklusion indigener Sprachen (Digital Inclusion of Indigenous Languages Initiative). Ihre Arbeit konzentriert sich darauf, die digitale Kluft zu überwinden, indem gefährdete Sprachen und Minderheitensprachen direkt in die Benutzeroberflächen von Mobiltelefonen integriert werden. Zugleich nutzen sie künstliche Intelligenz, um den Erhalt dieser Sprachen schneller und präziser voranzubringen.
Wir haben mit ihnen über Lenovos Vision für Minderheitensprachen weltweit und die Beweggründe hinter diesem Engagement gesprochen.
Sie beide leiten Motorolas Initiative zur digitalen Inklusion indigener Sprachen. Was war der entscheidende Moment, der Sie dazu bewogen hat, sich für sprachliche Gleichberechtigung einzusetzen? Spielt auch Ihr persönlicher Hintergrund oder eine Zugehörigkeit zu einer Minderheit eine Rolle für Ihr Engagement?
Janine Oliveira und Juliana Rebelatto: Der entscheidende Moment kam 2020/2021, als unser Globalisierungsteam bei Motorola eine digitale Kluft erkannte: Obwohl Smartphones weltweit für viele Menschen der wichtigste Zugang zu Informationen, Kommunikation und wirtschaftlicher Teilhabe sind, konnten Millionen von Angehörigen indigener Gemeinschaften und sprachlicher Minderheiten ihre Geräte überhaupt nicht in ihrer Muttersprache nutzen.
Laut UNESCO verschwindet alle zwei Wochen eine indigene Sprache. Damit sind mehr als 3.000 Sprachen vom Aussterben bis zum Ende dieses Jahrhunderts bedroht. Unser Globalisierungsteam beschloss deshalb, zur Wiederbelebung dieser Sprachen und zur Bewahrung ihrer kulturellen Kontinuität beizutragen. Im Jahr 2021 entwickelten wir die erste lokalisierte Benutzeroberfläche für Nheengatu, eine indigene Sprache, die im Amazonasgebiet gesprochen wird.
Geleitet von Lenovos Unternehmensmission „Smarter Technology for All“ sind wir überzeugt, dass die digitale Repräsentation indigener Sprachen und Minderheitensprachen dazu beitragen kann, die digitale Kluft zu überwinden und Bemühungen zur Wiederbelebung dieser Sprachen zu unterstützen. Zu erleben, wie Muttersprachler erstmals ein Smartphone in ihrer eigenen Sprache bedienen konnten, gab den Anstoß, aus einer Unternehmensinitiative ein langfristiges globales Engagement zu machen. Dieses steht im Einklang mit der Internationalen Dekade der indigenen Sprachen der UNESCO (2022–2032).
Eine gefährdete Sprache in ein modernes Smartphone zu integrieren, ist mit erheblichem Aufwand verbunden. Wie läuft dieser Prozess in der Praxis ab? Und wie gehen Sie mit der Übersetzung komplexer technischer Begriffe in Sprachen um, in denen es dafür möglicherweise noch keine entsprechenden Wörter gibt?
Unser Vorgehen basiert auf einem umfassenden Rahmenkonzept mit vier Säulen, das wir in unserem gemeinsam mit der UNESCO erarbeiteten Whitepaper ausführlich beschreiben:
Gefährdungsgrad der Sprache: Wir bewerten anhand der UNESCO-Klassifikationen, wie stark eine Sprache bedroht ist.
Stand der digitalen Inklusion: Wir untersuchen, inwieweit die Sprache bereits durch Unicode unterstützt wird und ob lokale Sprachdaten und geeignete Tastaturwerkzeuge vorhanden sind.
Zustimmung und Interesse der Sprachgemeinschaft: Wir arbeiten ausschließlich mit Gemeinschaften zusammen, die ausdrücklich digitale Werkzeuge für ihre Sprache wünschen. So stellen wir sicher, dass die Gemeinschaften selbst über den Prozess bestimmen und ihre Zustimmung geben.
Fachliche Expertise: Wir arbeiten mit lokalen Sprachwissenschaftlern, akademischen Einrichtungen und älteren Angehörigen der Sprachgemeinschaften zusammen. Beispiele sind die Freie Universität Bozen für das Ladinische und die Universität Campinas (UNICAMP) für lateinamerikanische Sprachen.
In der Praxis bedeutet die Lokalisierung einer mobilen Benutzeroberfläche, dass Zehntausende Textelemente einer Software manuell übersetzt, überprüft und angepasst werden müssen. Für die ladinische Benutzeroberfläche wurden beispielsweise mehr als 200.000 Wörter digitalisiert.
Besonders anspruchsvoll ist die Übersetzung komplexer technischer Begriffe, für die es in der jeweiligen Sprache noch keine Entsprechungen gibt. Dazu gehören beispielsweise Bezeichnungen für Kameraeinstellungen, biometrische Authentifizierungsverfahren wie die Gesichtserkennung zum Entsperren eines Geräts oder die Speicherung von Daten auf SD-Karten.
Anstatt direkte oder wörtliche Übersetzungen zu erzwingen, organisieren wir regionsübergreifende Workshops, bei denen Sprecher verschiedener regionaler Dialekte zusammenkommen. Im Fall des Ladinischen diskutierten beispielsweise Vertreter aus dem Gadertal, dem Fassatal und Fodom über die Entwicklung neuer Begriffe.
Gemeinsam mit Wissenschaftlern, darunter Professor Paul Videsott im Rahmen unserer Initiative zur Lokalisierung des Ladinischen, entwickelt die Sprachgemeinschaft neue technische Begriffe, die für die verschiedenen Sprechergruppen verständlich sind. Dabei werden die sprachlichen Regeln berücksichtigt und zugleich ein moderner Wortschatz für digitale Anwendungsbereiche geschaffen.
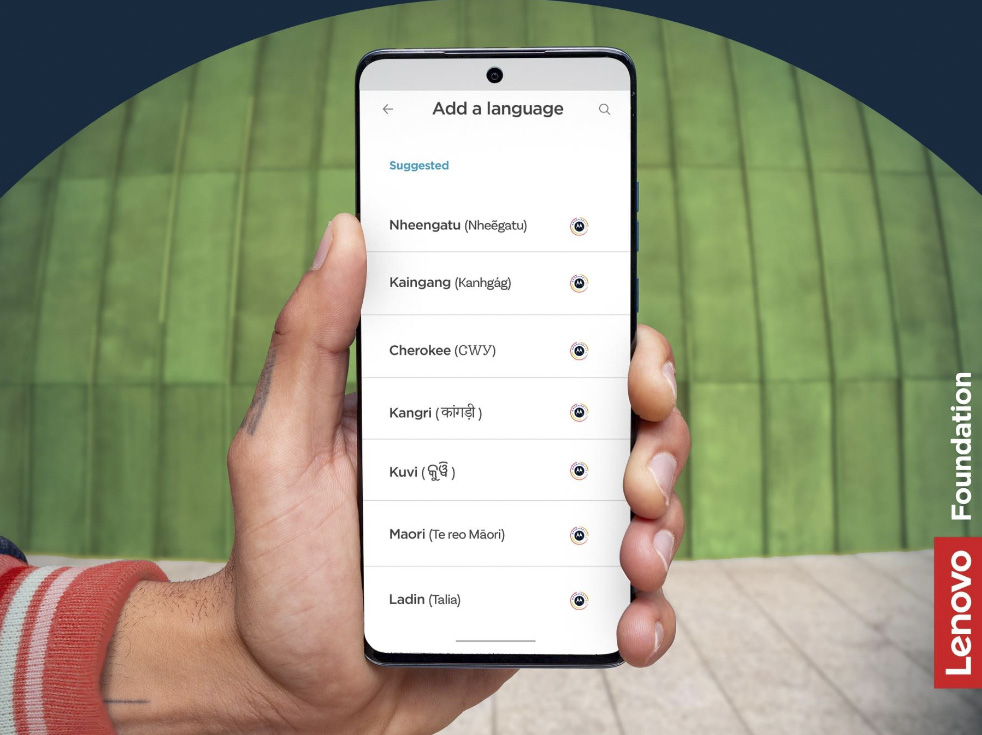
Titelillustration für „Hello Indigenous: ein Leitfaden zur Bewahrung gefährdeter indigener Sprachen durch digitale Inklusion“
Das diesjährige Forum beschäftigt sich mit den Risiken und Chancen künstlicher Intelligenz für Minderheiten. KI bietet ein enormes Potenzial, Übersetzungen zu beschleunigen und den Erhalt von Sprachen zu unterstützen. Wie setzt Lenovo KI ein, um die digitale Inklusion von Minderheitensprachen auszuweiten?
Bei Lenovo betrachten wir künstliche Intelligenz nicht als Ersatz für menschliche Kultur, sondern als ein leistungsfähiges Instrument zur Stärkung der sprachlichen Vielfalt. KI ermöglicht es uns, den Erhalt von Sprachen mit einer bisher nicht erreichten Geschwindigkeit und Präzision voranzubringen. Doch Technologie allein reicht dafür nicht aus.
Echte digitale Inklusion erfordert einen kontinuierlichen Austausch mit den lokalen Gemeinschaften. Wir müssen direkt mit ihnen zusammenarbeiten, ihre Bedingungen respektieren und uns an ihren Bedürfnissen orientieren. Entscheidend ist, dass unsere Bemühungen den Sprechern von Minderheitensprachen einen tatsächlichen und langfristigen Nutzen bringen.
Indem wir neue KI-Technologien mit Partnerschaften verbinden, bei denen die Sprachgemeinschaften selbst die Richtung vorgeben, können wir Werkzeuge entwickeln, die diese Sprachen und ihr kulturelles Erbe respektieren und dauerhaft unterstützen.
Ein Beispiel ist unsere Zusammenarbeit mit Samuell Frontull, einem Wissenschaftler der Universität Innsbruck. Durch die Integration unseres englisch-ladinischen Textkorpus für Motorola-Benutzeroberflächen in die maschinelle Übersetzungsplattform Tradutur konnten mehr als 1.000 zuvor nicht dokumentierte Wörter ergänzt werden.
Diese offene Integration führte zu erheblichen Qualitätsverbesserungen. Die Übersetzungsleistung in bestimmten Fachbereichen konnte deutlich gesteigert werden. Gleichzeitig verbesserte sich auch die allgemeine Übersetzungsqualität, gemessen an internationalen Benchmarks wie FLORES+ und BOUQUET.
Darüber hinaus haben wir mithilfe der GPU-Infrastruktur von Lenovo und in Zusammenarbeit mit den Eldorado-Forschungszentren das Modell LiLa entwickelt. Der Name setzt sich aus den jeweils ersten beiden Buchstaben von „Ligurian“ und „Ladin“ zusammen. LiLa ist ein spezialisiertes, weitertrainiertes KI-Modell mit 1,3 Milliarden Parametern, das auf NLLB basiert.
Bei der WMT 2026 belegte LiLa unter den offenen, reproduzierbaren Systemen für maschinelle Übersetzung sowohl für das Ligurische als auch für das Ladinische den ersten Platz.
Bei beiden Initiativen standen die ligurischen und ladinischen Sprachgemeinschaften im Mittelpunkt. Diese Beispiele zeigen, welche Ergebnisse sich durch gezielte Fachkenntnisse, Zusammenarbeit und technologische Innovation für bislang unzureichend berücksichtigte Sprachgemeinschaften erzielen lassen.
Auf der anderen Seite können KI-Systeme aufgrund des erheblichen Mangels an Daten über Minderheiten bestehende Diskriminierungen verstärken. Da große Sprachmodelle überwiegend mit Daten aus dominierenden Sprachen trainiert werden, was muss die Technologiebranche tun, um zu verhindern, dass KI die sprachliche Assimilation beschleunigt?
Damit künstliche Intelligenz nicht zu einem Instrument sprachlicher Assimilation wird, muss die Technologiebranche drei grundlegende Prinzipien beachten:
Datensouveränität und Kontrolle durch die Sprachgemeinschaften: Indigene Gemeinschaften und sprachliche Minderheiten müssen die vollständige Kontrolle über ihre Sprach-, Stimm- und Kulturdaten behalten. Die Erhebung von Daten muss auf ihrer Zustimmung beruhen. Die Gemeinschaften müssen selbst entscheiden können, wie ihre Daten verwendet und weitergegeben werden.
Vermeidung kultureller Vereinheitlichung und Aneignung: Große Sprachmodelle, die mit automatisch aus dem Internet gesammelten Daten trainiert werden, können dialektale Besonderheiten, kulturell sensible Zusammenhänge und komplexe soziale Strukturen ausblenden. Deshalb müssen die Sprachgemeinschaften aktiv an der Entwicklung von KI-Modellen beteiligt werden. Nur so lässt sich sicherstellen, dass kulturelle Zusammenhänge erhalten bleiben und sprachliche Unterschiede nicht eingeebnet werden.
Offene Bereitstellung hochwertiger Datensätze zur Überwindung des Datenmangels: Anstatt proprietäre, geschlossene Modelle zu entwickeln, die Daten von Minderheiten nutzen, ohne ihnen einen entsprechenden Nutzen zurückzugeben, sollten Hardwarehersteller und KI-Entwickler überprüfte Sprachkorpora mit Zustimmung der jeweiligen Gemeinschaften öffentlich zugänglich machen. Der Zugang zu hochwertigen Datensätzen ermöglicht es lokalen Wissenschaftlern, Lehrkräften und Entwicklern, eigene Werkzeuge zu schaffen. So können Minderheitensprachen gleichberechtigt am KI-Zeitalter teilhaben.
Ein wiederkehrendes Thema des Forums ist der bedeutende Beitrag von Minderheiten zur wirtschaftlichen und gesellschaftlichen Entwicklung. Große internationale Technologieunternehmen haben sich in der Vergangenheit vor allem auf die wirtschaftlich attraktivsten Sprachmärkte konzentriert. Wie gelingt es Ihnen, innerhalb des Unternehmens überzeugend darzulegen, dass die digitale Inklusion gefährdeter Sprachen eine nachhaltige Investition ist?
Unsere Initiative zur digitalen Inklusion ist weiterhin nicht gewinnorientiert und konzentriert sich auf die Bedürfnisse indigener Gemeinschaften und sprachlicher Minderheiten.
Ihr vorrangiges Ziel ist die gesellschaftliche Wirkung. Ihre langfristige Tragfähigkeit hängt jedoch davon ab, dass wir auch den strategischen Nutzen für das Unternehmen aufzeigen können.
Dazu müssen wir die Unternehmensperspektive mit langfristiger Verantwortung in den Bereichen Umwelt, Soziales und Unternehmensführung (ESG) sowie mit technologischer Innovation verbinden:
Ausrichtung an den ESG-Zielen des Unternehmens und der Internationalen Dekade der indigenen Sprachen: Indem wir zeigen, dass unsere Initiative mit globalen Zielen wie der Internationalen Dekade der indigenen Sprachen der UNESCO übereinstimmt, positionieren wir das Unternehmen als Vorreiter bei gesellschaftlicher Unternehmensverantwortung sowie bei Vielfalt, Chancengerechtigkeit, Inklusion und Zugehörigkeit (DEIB).
Internationale Anerkennung und Stärkung der Markenbindung: Die Initiative wurde mit bedeutenden Branchenpreisen ausgezeichnet, darunter dem Engage for Good Gold Halo Award (2025) und dem Tom’s Guide Diversity in Tech Award (2023). Darüber hinaus wurde sie in wissenschaftlichen Veröffentlichungen wie dem European Journal of Minority Studies und der Reihe Studies of Computational Intelligence zitiert.
Medienkampagnen zur Einführung neuer Angebote, beispielsweise einer Tastatur für das Zapotekische, erzielten in wichtigen Märkten mehr als 24 Millionen Impressionen.
Nutzen für Forschung, Entwicklung und KI-Infrastruktur: Sowohl die offene Bereitstellung von Daten als auch die Standardisierung der Lokalisierung für Sprachen mit geringen digitalen Ressourcen verbessern unmittelbar die grundlegende Softwarearchitektur, die Unicode-Unterstützung und die Prozesse für KI-gestützte und maschinelle Übersetzungen. Durch die Veröffentlichung offener Daten, die Entwicklung effizienter Modelle wie LiLa und den Aufbau frei zugänglicher Sprachkorpora schaffen wir wiederverwendbare technologische Grundlagen. Diese senken langfristig die Kosten für die Lokalisierung und ermöglichen standardisierte Verfahren, die sich auf weitere Märkte übertragen lassen.
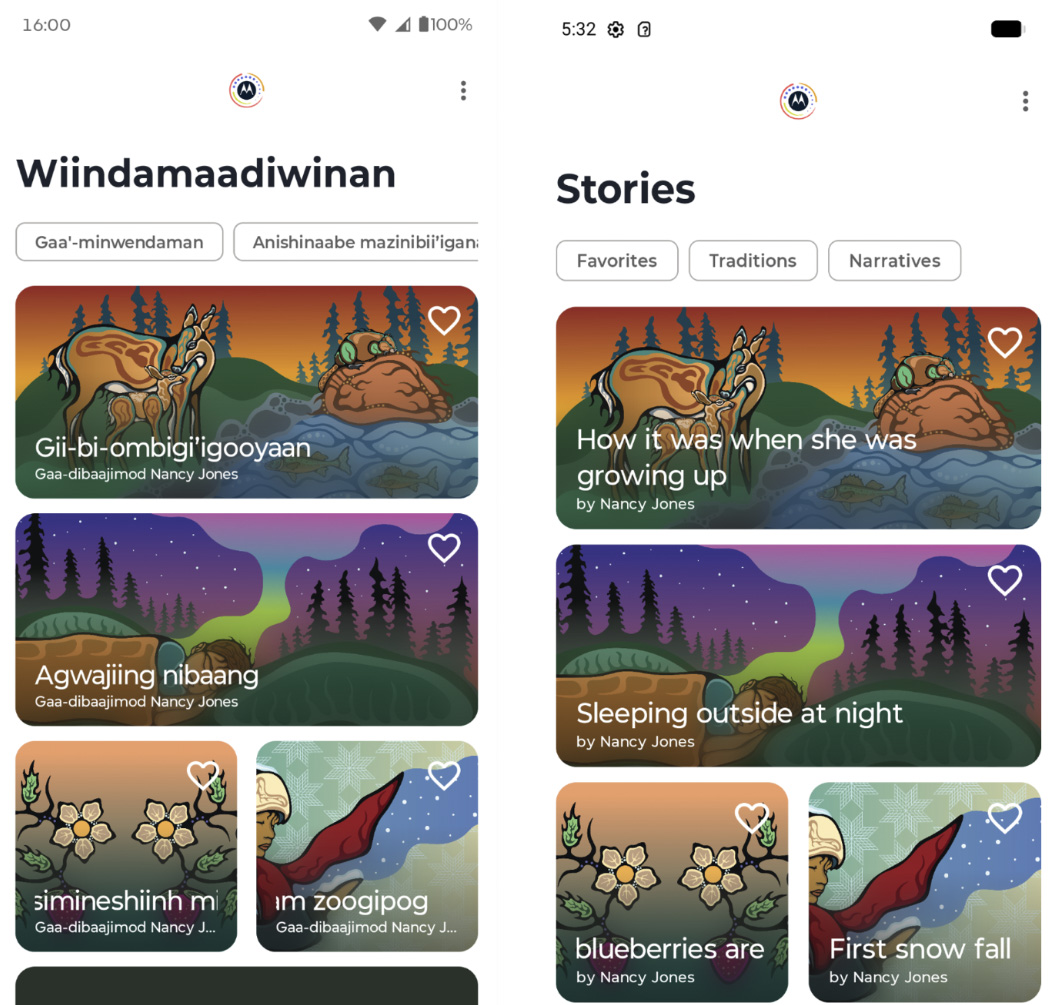
Illustrationen: Die von Motorola entwickelte App „Indigenous Collections“, die dazu geschaffen wurde, das Erbe der Ojibwe zu entdecken, zu bewahren und zu feiern.
Ihre Initiative hat bereits erfolgreich Geräte für Minderheitensprachen in Regionen wie den Dolomiten lokalisiert. Wie können politische Entscheidungsträger auf regionaler Ebene in Europa, die am Forum teilnehmen, aktiv mit Hardwareherstellern zusammenarbeiten, damit ihre Sprachen einen festen Platz im digitalen Ökosystem erhalten?
Europäische Regionalpolitiker können an den Erfolg des ladinischen Modells aus den Dolomiten anknüpfen, indem sie vier konkrete Maßnahmen ergreifen:
Partnerschaften zwischen verschiedenen Akteuren aufbauen: Regionale Entscheidungsträger sollten als Bindeglied zwischen kulturellen Einrichtungen, sprachwissenschaftlichen Instituten an Universitäten und Technologieherstellern fungieren. In Südtirol und den Dolomiten war die Zusammenarbeit zwischen der Freien Universität Bozen, den ladinischen Kulturinstituten und Motorola entscheidend für die Entwicklung einer vollständig lokalisierten ladinischen Benutzeroberfläche.
Die regionale Digitalisierung und offene Sprachkorpora fördern: Investitionen in die Vereinheitlichung digitaler Rechtschreibstandards, die Erstellung digitaler Wörterbücher und den Aufbau frei zugänglicher Sprachkorpora sind von zentraler Bedeutung. Wenn eine Region einen gut strukturierten, hochwertigen Datensatz bereitstellt, können Hardwarehersteller die betreffende Sprache wesentlich schneller in Betriebssysteme integrieren.
Gemeinsam in KI- und GPU-Infrastruktur investieren: Regionalregierungen können mit Technologieunternehmen zusammenarbeiten, um die erforderliche Rechenleistung für die Weiterentwicklung quelloffener maschineller Übersetzungssysteme wie Tradutur und LiLa zu finanzieren. Dadurch lässt sich sicherstellen, dass die betreffenden Sprachen auch in der nächsten Generation von KI-Anwendungen vertreten sind.
Digitale Werkzeuge in Bildung und Verwaltung verankern: Der Einsatz von Mobilgeräten mit lokalisierten Benutzeroberflächen und entsprechenden digitalen Anwendungen sollte in schulischen Lehrplänen und in der öffentlichen Verwaltung verbindlich vorgesehen werden. Dadurch lässt sich insbesondere bei jüngeren Generationen die alltägliche Nutzung der Minderheitensprachen im digitalen Bereich fördern.
Wenn Sie einen verbindlichen Branchenstandard dafür festlegen könnten, wie KI-Entwickler und Hersteller technologischer Geräte weltweit mit sprachlicher Vielfalt umgehen, wie würde dieser aussehen?
Wir würden einen „Standard für gemeinschaftsorientierte digitale Souveränität und offene Daten“ (Community-First Digital Sovereignty & Open Data Standard) für Technologieentwickler weltweit einführen.
Nach diesem Standard müssten alle Hardwarehersteller und KI-Entwickler, die Minderheitensprachen oder indigene Sprachen digitalisieren oder KI-Modelle mit entsprechenden Sprachdaten trainieren möchten, folgende Anforderungen erfüllen:
Verbindliche Mitbestimmung der Sprachgemeinschaften: Vor der Erhebung oder Verarbeitung von Sprachdaten müssen die Unternehmen die ausdrückliche Zustimmung der jeweiligen Gemeinschaft einholen. Außerdem müssen sie direkt mit anerkannten älteren Vertretern der Gemeinschaft, Sprachwissenschaftlern und kulturellen Einrichtungen zusammenarbeiten.
Offene Bereitstellung von Systemterminologie und Sprachkorpora: In Abstimmung mit der jeweiligen Sprachgemeinschaft müssen grundlegende Lokalisierungen von Benutzeroberflächen, technische Glossare und anonymisierte Übersetzungsdatensätze, die von großen Technologieunternehmen finanziert oder erstellt werden, als offene Ressourcen veröffentlicht werden.
Verbindliche ethische Bewertungsmaßstäbe für KI: KI-Modelle, die in öffentlichen Systemen eingesetzt werden, müssen anhand festgelegter Kriterien auf ihre Genauigkeit bei Sprachen mit begrenzten digitalen Ressourcen, die authentische Wiedergabe regionaler Dialekte und die Bewahrung kultureller Zusammenhänge überprüft werden. Dadurch soll sichergestellt werden, dass Minderheitensprachen mit derselben Qualität, demselben Respekt und derselben Genauigkeit behandelt werden wie die Sprachen großer Märkte.
Diskutieren Sie mit in Chur
Beim 10. Forum Europäischer Minderheitenregionen haben die Teilnehmerinnen und Teilnehmer die Gelegenheit, direkt mit Janine Oliveira, Juliana Rebelatto sowie weiteren Fachleuten, politischen Entscheidungsträgern und Vertretern von Minderheiten ins Gespräch zu kommen.
Interessierte und Vertreter von Organisationen können die beiden Referentinnen und die weiteren Mitwirkenden am 23. Oktober 2026 in Chur/Cuira/Coira treffen, Erfahrungen austauschen, neue Ansätze kennenlernen und gemeinsam darüber diskutieren, wie sich Minderheitensprachen im Zeitalter der künstlichen Intelligenz erhalten und fördern lassen.
Pressemitteilungen
- Türkische Minderheiten und Gemeinschaften versammeln sich in Skopje, der Hauptstadt Nordmazedoniens
- Björn Teir: Was wir heute nicht digitalisieren, ist morgen für die Welt nicht sichtbar
- 8. Jahrestagung der FUEN-Arbeitsgemeinschaft Bildung: Berufliche Bildung, Minderheitensprachen und KI im Fokus
- Die FUEN erörterte Minderheitenfragen mit EU-Institutionen in Brüssel
- FUEN-Ausstellung im Europäischen Parlament eröffnet: Minderheitensprachen auf die europäische Agenda bringen
- FUEN-Arbeitsgemeinschaft Bildung trifft sich in Eupen: Berufliche Bildung, Minderheitensprachen und KI im Fokus
- FUEN-Delegiertenversammlung 2026 fordert stärkere Berücksichtigung von Minderheitensprachen bei künstlicher Intelligenz
- FUEN-Kongress diskutiert über Geoblocking und den Schutz von Minderheitensprachen
- FUEN-Kongress untersucht den muttersprachlichen Zugang zu Gesundheits- und Sozialdiensten
- FUEN-Kongress beleuchtet die Zukunft von Minderheitensprachen im öffentlich-rechtlichen Rundfunk