






Azınlıklar ve Yapay Zeka: Dijital Çağa Mirasın Kodlanması
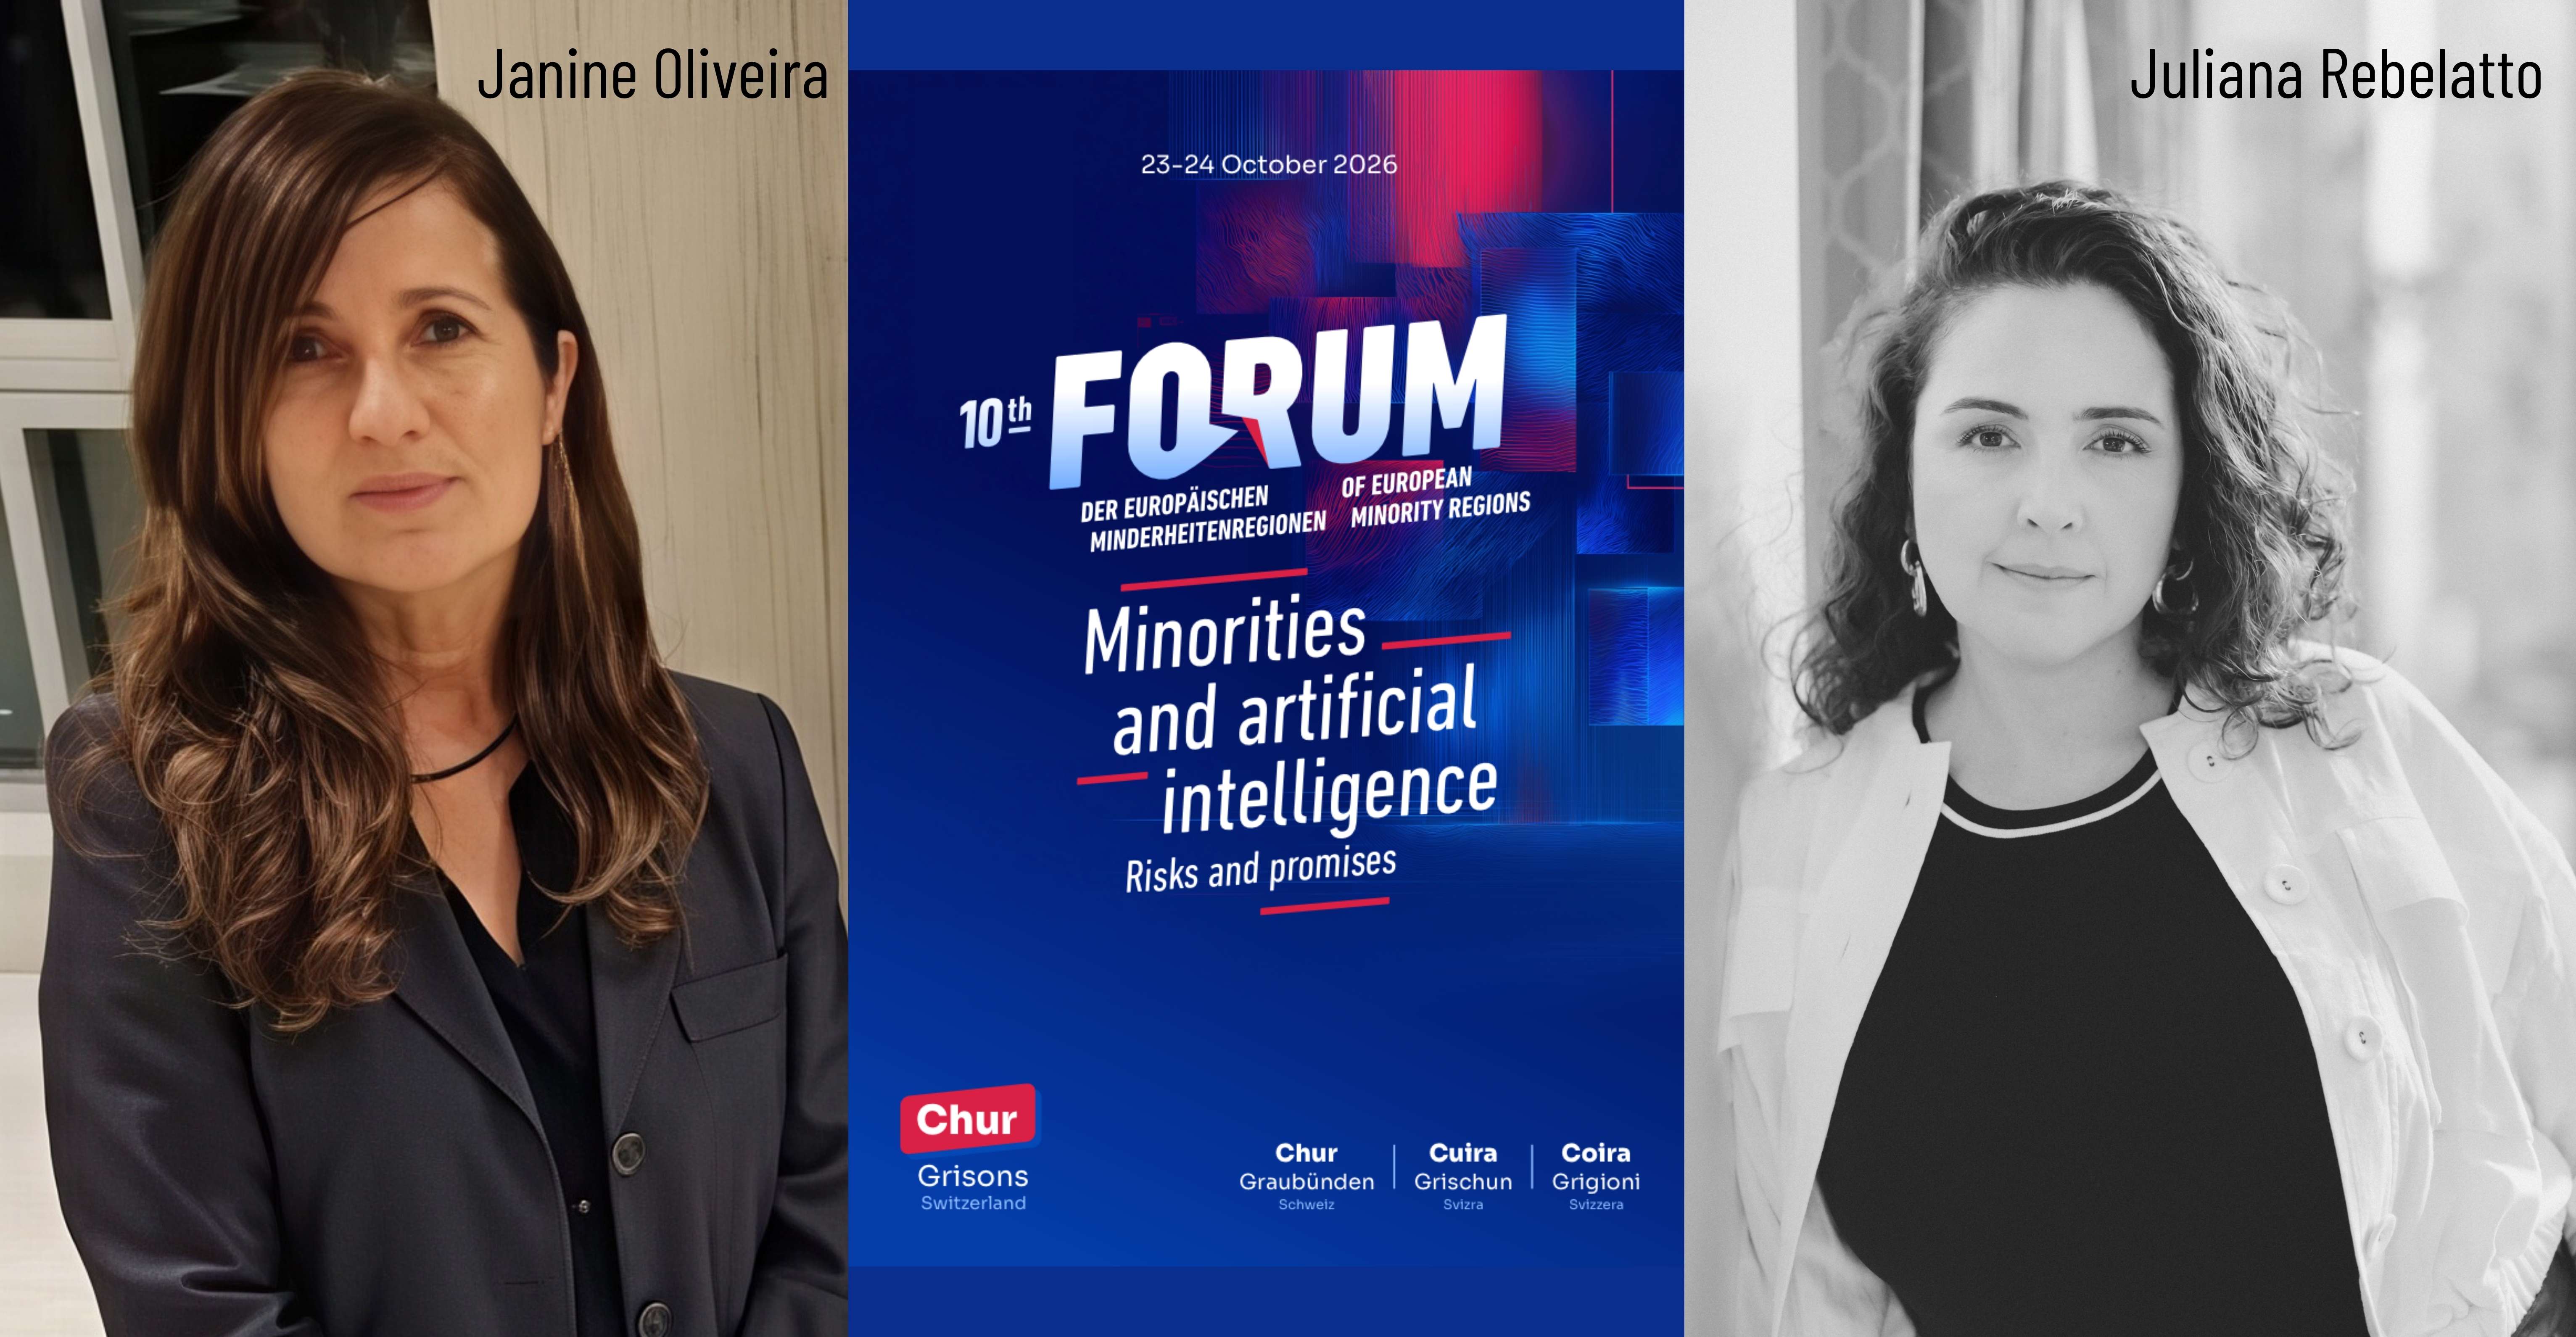
16.10.2026Yapay zekanın hızlı ilerlemesi, Avrupa genelinde azınlık dillerinin ve kültürel kimliklerin korunması açısından benzeri görülmemiş fırsatlar ve önemli zorluklar ortaya koymaktadır. Bu hayati dinamikleri ele almak üzere, 10. Avrupa Azınlık Bölgeleri Forumu 23 ve 24 Ekim 2026 tarihlerinde İsviçre’nin Chur/Cuira/Coira kentinde düzenlenecektir. “Azınlıklar ve Yapay Zeka – Riskler ve Umutlar” teması etrafında şekillenecek olan Forum, bölgesel liderleri, kültür çalışanlarını, araştırmacıları ve azınlık savunucularını bir araya getirerek, yeni teknolojilerin az kullanılan diller üzerinde nasıl bir etki yarattığını ve dijital çağda azınlık mirasının gelişmesini sağlayacak stratejilerin neler olduğunu ele alacak. Katılımcılar, etkinlik sırasında yapay zeka cihazları ve projeleriyle etkileşim kurma fırsatı bulacak.
Bu yılki diyaloga katılan seçkin konuşmacılar arasında Janine Oliveira ve Juliana Rebelatto yer alıyor. Janine Oliveira, Lenovo’da İş Geliştirme İcra Direktörü ve Tehlike Altındaki Azınlık Dilleri ESG Girişimi Lideri olarak görev yapmaktadır. Juliana Rebelatto ise Lenovo MBG’nin Küreselleşme Başkanı ve Tehlike Altındaki Azınlık Dilleri ESG Girişimi Lideri’dir. İkili, Motorola’nın Yerli Dillerin Dijital Kapsayıcılığı Girişimi’ne öncülük etmektedir. Çalışmaları, tehlike altındaki ve azınlık dillerini mobil kullanıcı arayüzlerine doğrudan entegre ederek ve yapay zekayı kullanarak dil korumasını benzeri görülmemiş bir hız ve hassasiyetle genişletmek suretiyle küresel dijital uçurumu kapatmaya odaklanmaktadır.
Onlarla Lenovo’nun küresel azınlık dilleri konusundaki vizyonu ve bunun ardındaki motivasyonlar hakkında konuştuk.
İkiniz de Motorola’nın Yerli Dillerin Dijital Kapsayıcılığı Girişimi’ne öncülük ediyorsunuz. Dil eşitliği konusunu ele almaya sizi motive eden belirleyici an neydi ve kişisel ya da azınlık kökeniniz, bu işe duyduğunuz tutkuyu etkiliyor mu?
Janine Oliveira ve Juliana Rebelatto: – Belirleyici an, 2020-2021 yıllarında Motorola’daki Küreselleşme ekibimizin bir dijital uçurumun farkına varmasıyla geldi: Akıllı telefonlar küresel olarak bilgiye erişim, bağlantı ve ekonomik katılım için birincil kapı olmasına rağmen, milyonlarca yerli ve azınlık dili konuşan kişi, cihazlarıyla kendi ana dillerinde etkileşim kurmaktan tamamen mahrum kalıyordu.
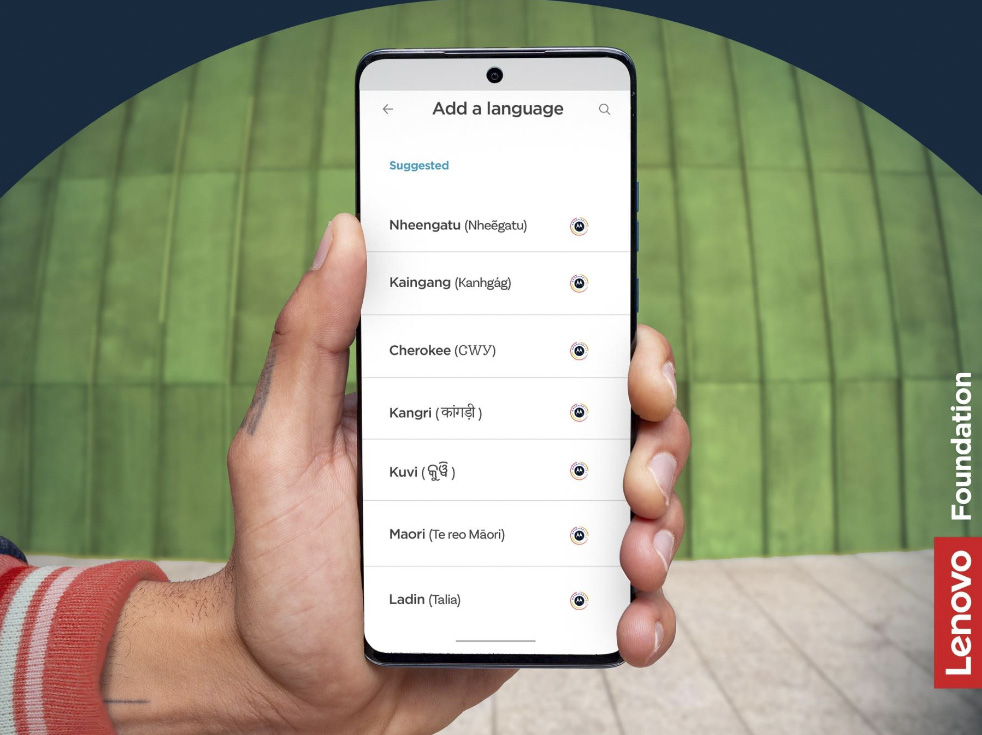
UNESCO’ya göre, her iki haftada bir yerli dil yok oluyor ve bu durum, yüzyıl sonuna kadar 3.000’den fazla benzersiz dilin yok olma riskiyle karşı karşıya kalmasına neden oluyor. Bu nedenle Küreselleştirme ekibimiz, 2021 yılında Amazon’da konuşulan bir yerli dil olan Nheengatu için ilk kullanıcı arayüzü yerelleştirmesini oluşturarak dilin yeniden canlandırılmasına ve kültürel sürekliliğe katkıda bulunmaya karar verdi.
Lenovo’nun “Herkes İçin Daha Akıllı Teknoloji” temel misyonundan ilham alarak, yerli ve azınlık dillerinin dijital ortamda temsil edilmesinin hem dijital uçurumu kapatacağına hem de dil canlandırma çabalarına yardımcı olacağına inanıyoruz. Ana dilini konuşan kişilerin ilk kez kendi dillerinde bir akıllı telefonla etkileşim kurduğunu görmek, kurumsal bir girişimi UNESCO’nun Uluslararası Yerli Diller On Yılı (2022-2032) ile uyumlu, uzun vadeli küresel bir harekete dönüştürmemiz için itici güç oldu.
Tehlike altındaki bir dili modern bir akıllı telefona entegre etmek, devasa bir operasyonel girişimdir. Bu süreç sahada gerçekte nasıl işliyor ve karmaşık teknik terimleri, henüz eşdeğer kelimeleri bulunmayan dillere nasıl çeviriyorsunuz?
– Sürecimiz, titiz dört temelli bir çerçeveye tabidir (ayrıntıları, UNESCO ile ortaklaşa hazırladığımız Beyaz Kitap’ta yer almaktadır):
Dilin Tehlike Altında Olma Durumu: UNESCO sınıflandırmalarını kullanarak tehdit seviyelerini değerlendirme.
Dijital Kapsayıcılık Durumu: Mevcut Unicode desteği, yerel veriler ve klavye araçlarının değerlendirilmesi.
Topluluk Konsensüsü ve İsteği: Tam sahiplik ve rızayı sağlamak için yalnızca dijital dil araçlarını aktif olarak arayan topluluklarla ortaklık kurmak.
Konu Uzmanlığı: Yerel dilbilimciler, akademik kurumlar ve yaşlılarla ortaklık kurmak (örneğin, Ladin dili için Bozen-Bolzano Özgür Üniversitesi veya Latin Amerika dilleri için UNICAMP).
Operasyonel açıdan, bir mobil kullanıcı arayüzünü (UI) yerelleştirmek, Ladin UI için dijitalleştirilen 200.000'den fazla kelime gibi on binlerce yazılım dizesinin özenle hazırlanması, gözden geçirilmesi ve çevrilmesini gerektirir.
Eşdeğer kelimelerin bulunmadığı karmaşık teknik terminolojiyi ele almak (örneğin, kamera ayarları, “Yüz Tanıma” gibi biyometrik kimlik doğrulama veya SD kart depolama terimleri), dilbilimsel yenilikçilik gerektirir. Doğrudan veya kelimesi kelimesine çevirileri dayatmak yerine, farklı bölgesel lehçelerden konuşmacıları bir araya getiren bölgeler arası atölye çalışmaları düzenliyoruz (örneğin Ladin dilinde, Val Badia, Fassa ve Fodom’dan temsilciler kelime yeniliklerini tartıştı). Ladin yerelleştirme girişimimizde olduğu gibi Profesör Paul Videsott gibi akademisyenlerle birlikte, topluluk, dilin dilbilimsel kurallarına saygı gösterirken dijital alanlar için modern bir kelime dağarcığı oluşturarak, karşılıklı olarak anlaşılabilir yeni teknik terimler yaratıyor.
İllüstrasyon: “Hello Indigenous: Dijital Kapsayıcılık Yoluyla Tehlike Altındaki Yerli Dillerin Korunmasına İlişkin Bir Plan” kitabının kapak illüstrasyonu
Bu yılki Forum teması, azınlıklar için yapay zekanın (AI) getirdiği riskler ve vaatlere odaklanıyor. Yapay zeka, çeviri ve dil korumasını hızlandırmak için muazzam bir potansiyele sahiptir. Lenovo, azınlık dillerinin dijital kapsayıcılığını genişletmek için yapay zekayı nasıl kullanıyor?
– Lenovo olarak, yapay zekayı insan kültürünün yerine geçecek bir unsur olarak değil, dilsel çeşitliliği güçlendiren etkili bir araç olarak görüyoruz. Yapay zeka, dil koruma çalışmalarını benzeri görülmemiş bir hız ve hassasiyetle genişletmemizi sağlıyor; ancak teknoloji tek başına denklemin sadece yarısını oluşturuyor. Gerçek dijital kapsayıcılık, yerel topluluklarla sürekli etkileşim kurmayı, onların şartlarına göre ve kendileri için mantıklı olduğu zamanlarda doğrudan işbirliği yapmayı ve çabalarımızın azınlık dili konuşanlara gerçek ve uzun vadeli bir değer katmasını sağlamayı gerektirir. En son yapay zeka yeniliklerini topluluk öncülüğündeki ortaklıklarla birleştirerek, bu eşsiz miras dillerine gerçekten saygı duyan ve onları sürdüren araçlar geliştirebiliriz.
Innsbruck Üniversitesi’nden araştırmacı Samuell Frontull ile yaptığımız işbirliği kapsamında, Motorola'nın İngilizce-Ladin kullanıcı arayüzü (UI) metin derlemesi, Ladin dili için bir Makine Çevirisi (MT) platformu olan Tradutur'a daha önce belgelenmemiş 1.000'den fazla kelime ekledi. Bu açık entegrasyon, kalite açısından çarpıcı iyileşmeler sağladı; alana özgü çeviri puanlarını artırırken, aynı zamanda FLORES+ ve BOUQUET gibi küresel karşılaştırma ölçütlerinde genel çeviri performansını da geliştirdi.
Ayrıca, Lenovo’nun GPU altyapısını kullanarak ve Eldorado araştırma merkezleriyle işbirliği yaparak, “Ligurian Ladin” ifadesinin ilk iki harfinin birleşiminden adını alan LiLa’yı geliştirdik. LiLa, NLLB’ye dayanan, özel olarak tasarlanmış ve ince ayarlanmış 1,3 milyar parametreli bir modeldir. WMT 2026’da LiLa, hem Ligurca hem de Ladin dili için açık ve tekrarlanabilir makine çevirisi sistemleri arasında 1. sırada yer aldı. Bu iki girişimin her ikisinde de Ligurya ve Ladin toplulukları ön saflarda yer aldı. Bu durum, odaklanmış uzmanlık, işbirliği ve inovasyonun, yeterince destek görmeyen dil toplulukları için nasıl anlamlı bir etki yaratabileceğini göstermektedir.
Öte yandan, yapay zeka sistemleri, azınlık gruplarına yönelik ciddi veri eksiklikleri nedeniyle ayrımcılığı kolayca pekiştirebilir. Büyük dil modelleri ezici bir çoğunlukla baskın diller üzerinde eğitildiğine göre, teknoloji endüstrisi, yapay zekanın dilsel asimilasyonu hızlandırmasını önlemek için ne yapmalıdır?
– Yapay zekanın dilsel asimilasyonun bir aracı haline gelmesini önlemek için teknoloji endüstrisi üç temel ilkeye bağlı kalmalıdır:
Veri Egemenliği ve Topluluk Sahipliği: Yerli ve azınlık toplulukları, dilleri, sesleri ve kültürel verileri üzerinde mutlak sahiplik ve yönetim hakkını elinde tutmalıdır. Veri toplama, rıza temelli olmalı ve toplulukların verilerinin nasıl kullanılacağına ve paylaşılacağına kendilerinin karar vermesini sağlamalıdır.
Kültürel Düzleşmeyi ve Kültürel Sömürüyü Azaltmak: Web’den toplanan verilerle eğitilen büyük dil modelleri, genellikle lehçesel nüansları, kutsal bağlamları ve karmaşık sosyal yapıları ortadan kaldırır. Yapay zeka modelleri, dilleri düzleştirmek yerine tam kültürel bağlamları korumak için topluluk odaklı geliştirme süreçlerini içermelidir.
Veri Kıtlığını Gidermek İçin Kaliteli Veri Kümelerinin Açık Kaynak Olarak Paylaşılması: Donanım üreticileri ve yapay zeka geliştiricileri, azınlık verilerini hiçbir karşılık vermeden sömüren tescilli, kapalı kaynaklı modeller oluşturmak yerine, topluluğun rızasıyla doğrulanmış metin derlemelerini açık kaynak olarak paylaşmalıdır. Yüksek kaliteli veri kümelerinin paylaşılması, yerel araştırmacıların, eğitimcilerin ve geliştiricilerin kendi araçlarını oluşturmalarını sağlayarak azınlık dillerinin yapay zeka çağında tam olarak yer almasını garanti eder.
Forumda sıkça gündeme gelen bir konu, azınlıkların ekonomik ve sosyal kalkınmaya önemli katkıda bulunmasıdır. Küresel teknoloji devleri tarihsel olarak en zengin dil pazarlarına odaklandıklarına göre, tehlike altındaki dillerin dijital kapsayıcılığının sürdürülebilir bir yatırım olduğu konusunda şirket içinde nasıl başarılı bir iş gerekçesi ortaya koyabilirsiniz?
– Dijital Kapsayıcılık girişimi, kâr amacı gütmeyen bir yapıya sahip olmaya devam ederek, yerli ve azınlık dil topluluklarının ihtiyaçlarına odaklanmaktadır. Birincil hedefi sosyal etki olsa da, sürdürülebilirliği iş dünyasına stratejik değerini kanıtlamasına bağlıdır. Bu, kurumsal bakış açısını uzun vadeli ESG (Çevresel, Sosyal ve Yönetişim) liderliği ve teknoloji inovasyonuyla uyumlu hale getirmeyi gerektirir:
Temel Kurumsal ESG ve IDIL Uyumu: UNESCO’nun Uluslararası Yerli Diller On Yılı gibi küresel hedeflerle uyumu göstermek, şirketi Kurumsal Vatandaşlık ve DEIB (Çeşitlilik, Eşitlik, Kapsayıcılık ve Aidiyet) alanlarında öncü bir lider olarak konumlandırır.
Küresel Sektör Tanınırlığı ve Marka Bağlılığı: Girişim, Engage for Good Gold Halo Ödülü (2025) ve Tom's Guide Teknolojide Çeşitlilik Ödülü (2023) dahil olmak üzere sektörün en prestijli ödüllerini kazanmış; ayrıca Avrupa Azınlık Çalışmaları Dergisi ve Hesaplamalı Zeka Çalışmaları dergilerinde akademik atıflar almıştır. Zapotek klavyesi gibi lansmanlara yönelik medya kampanyaları, başlıca pazarlarda 24 milyondan fazla gösterim elde etmiştir.
Ar-Ge ve Yapay Zeka Altyapısı Değeri: Hem verilerin açık kaynak haline getirilmesi hem de kaynak kısıtlı yerelleştirmelerin standartlaştırılması, temel yazılım mimarisini, Unicode desteğini ve yapay zeka/makine çevirisi (AI/MT) iş akışlarını doğrudan güçlendirir. Verileri açık kaynak haline getirmenin yanı sıra verimli modeller (LiLa gibi) ve açık kaynak metin derlemeleri oluşturarak, uzun vadeli yerelleştirme maliyetlerini düşüren ve yeni pazar genişlemeleri için ölçeklenebilir çerçeveler kuran, yeniden kullanılabilir teknolojik varlıklar yaratıyoruz.
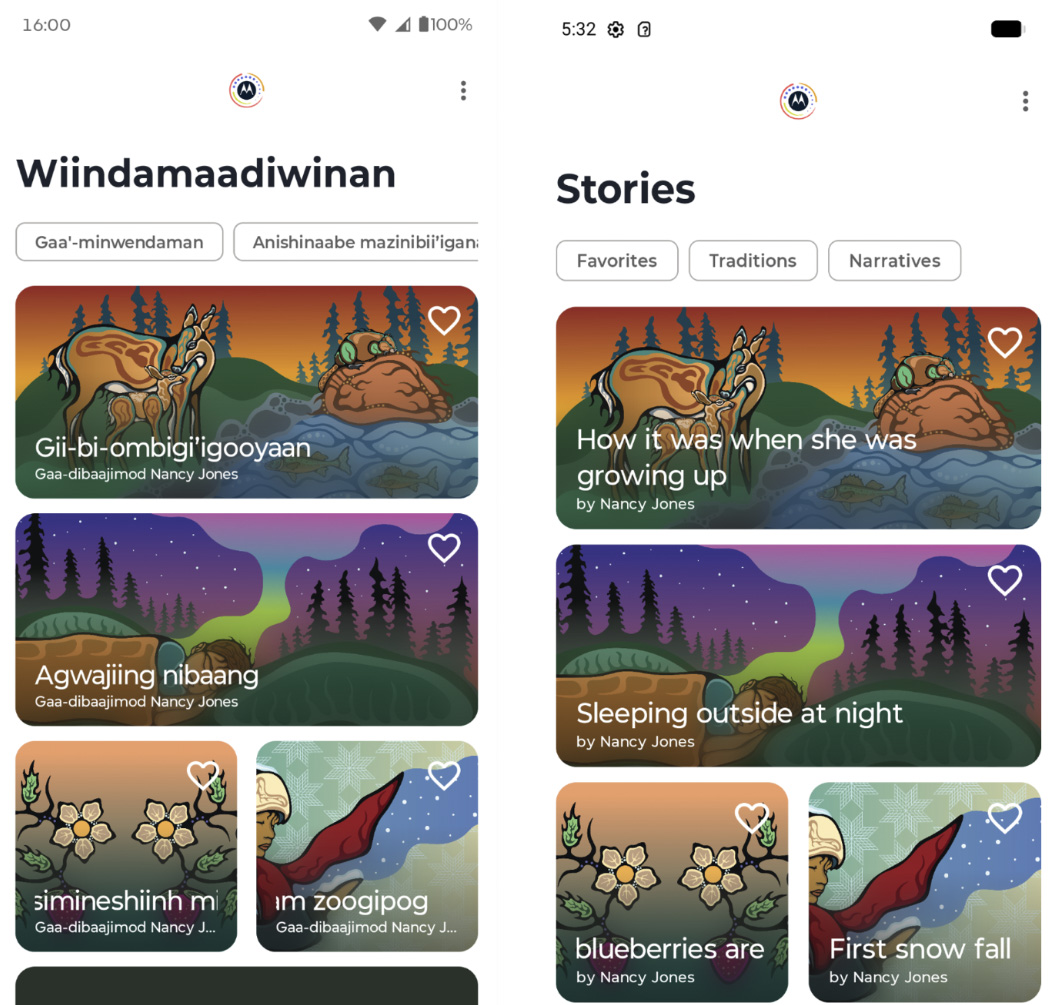
Örnekler: Ojibwe mirasını keşfetmek, korumak ve kutlamak amacıyla Motorola tarafından geliştirilen Indigenous Collections uygulaması
Girişiminiz, Dolomitler gibi bölgelerdeki azınlık dilleri için cihazların yerelleştirilmesini başarıyla gerçekleştirmiştir. Bu Foruma katılan Avrupalı bölgesel politika yapıcılar, dillerinin dijital ekosistemde yer bulmasını sağlamak için donanım üreticileriyle nasıl proaktif bir şekilde iş birliği yapabilirler?
– Avrupalı bölgesel politika yapıcılar, dört somut adım atarak Dolomitler (Ladin) modelinin başarısını tekrarlayabilirler:
Çok Paydaşlı Ortaklıklar Kurun: Bölgesel kültür kurumları, üniversite dil bölümleri ve teknoloji OEM’leri arasında bir köprü görevi görün. Güney Tirol/Dolomitler’de, Bozen-Bolzano Özgür Üniversitesi, Ladin Kültür Enstitüleri ve Motorola arasındaki işbirliği, tamamen yerelleştirilmiş bir Ladin kullanıcı arayüzü sunmak için hayati öneme sahipti.
Bölgesel Dijitalleştirme ve Açık Metin Derlemelerine Odaklanmak: Dijital yazım kurallarının standartlaştırılması, dijitalleştirilmiş sözlüklerin oluşturulması ve açık erişimli metin derlemelerinin üretilmesi için araştırma çabalarına yatırım yapmak. Bir bölge, organize ve yüksek kaliteli bir veri seti sunduğunda, donanım üreticileri bu dili işletim sistemlerine çok daha hızlı bir şekilde entegre edebilir.
AI ve GPU Altyapısına Ortak Yatırım: Bölgesel hükümetler, teknoloji liderleriyle iş birliği yaparak açık kaynaklı makine çevirisi sistemlerinin (Tradutur ve LiLa gibi) ince ayarları için hesaplama kaynaklarını finanse edebilir ve böylece yeni nesil AI araçlarında dijital temsili garanti altına alabilir.
Politika ve Eğitim Entegrasyonu: Genç nesiller arasında günlük dijital kullanımı teşvik etmek amacıyla, yerel okul müfredatlarında ve kamu yönetiminde yerelleştirilmiş mobil teknoloji ve dijital araçların kullanımını zorunlu kılın.
AI geliştiricilerinin ve teknoloji donanım şirketlerinin küresel dilsel çeşitliliğe yaklaşımına ilişkin tek bir zorunlu endüstri standardı belirleyebilseydiniz, bu standart nasıl olurdu?
– Küresel teknoloji geliştiricileri için “Topluluk Öncelikli Dijital Egemenlik ve Açık Veri Standardı”nı oluştururduk.
Bu standart kapsamında, azınlık dilleri veya yerli diller üzerinde modelleri dijitalleştirmek veya eğitmek isteyen herhangi bir donanım OEM’i veya AI geliştiricisi şunları yapmakla yükümlü olacaktır:
Topluluk Yönetişimini Zorunlu Kılmak: Dil verilerini toplamadan veya işlemeden önce açık rıza almak ve tanınmış topluluk büyükleri, dilbilimciler ve kültürel kurumlarla doğrudan ortaklık kurmak.
Açık Kaynak Sistem Terminolojisi ve Metin Derlemeleri: İlgili toplulukla uyumlu olarak, büyük teknoloji firmaları tarafından finanse edilen veya üretilen tüm temel kullanıcı arayüzü yerelleştirmelerinin, teknik sözlüklerin ve anonimleştirilmiş çeviri veri kümelerinin açık kaynak olarak yayınlanmasını zorunlu kılmak.
Etik Yapay Zeka Değerlendirme Kriterlerini Uygulama: Kamu sistemlerinde kullanılan yapay zeka modellerinin, kaynakları kısıtlı dillerde doğruluk, lehçe özgünlüğü ve kültürel bağlamın korunması açısından değerlendirilmesini zorunlu kılmak. Bu, azınlık dil topluluklarına, baskın dil pazarlarıyla eşit kalite, saygınlık ve doğrulukta hizmet sunulmasını sağlar.
Chur’daki Tartışmaya Katılın
Katılımcılar, 10. Avrupa Azınlık Bölgeleri Forumu’nda Janine Oliveira, Juliana Rebelatto ve uzman konuşmacılar, politika yapıcılar ve azınlık temsilcilerinden oluşan çok çeşitli bir panel ile doğrudan etkileşim kurma fırsatına sahip olacaklar. İlgilenen kişiler ve temsilciler, 23 Ekim 2026 tarihinde Chur/Cuira/Coira’da bu isimler ve diğer konuşmacılarla bir araya gelerek görüşlerini paylaşabilir, yenilikçi stratejileri keşfedebilir ve Yapay Zeka çağında azınlık dillerinin korunmasının geleceğini şekillendirebilirler.
Basın bildirileri
- Azınlıklar ve Yapay Zeka: Dijital Çağda Lehçelere Hayat Vermek
- Türk azınlık ve toplulukları Kuzey Makedonya’nın başkenti Üsküp’te buluşuyor
- Björn Teir: Bugün dijitalleştirmediğimiz şeyler, yarın dünya tarafından görülemez
- FUEN Eğitim Çalışma Grubu’nun 8. Yıllık Toplantısı: Mesleki eğitim, azınlık dilleri ve yapay zeka odak noktasında
- FUEN, Brüksel’de AB kurumlarıyla azınlık meselelerini görüştü
- FUEN sergisi Avrupa Parlamentosu’nda açıldı: Azınlık dillerini Avrupa gündemine taşımak
- FUEN Eğitim Çalışma Grubu Eupen’de toplanıyor: Mesleki eğitim, azınlık dilleri ve yapay zeka odak noktasında
- FUEN 2026 Delege Meclisi, yapay zekâda azınlık dillerinin daha fazla dahil edilmesini talep ediyor
- FUEN Kongresi, coğrafi engelleme ve azınlık dillerinin korunmasını ele aldı
- FUEN Kongresi, Sağlık ve Sosyal Hizmetlerde Ana Dilde Hizmet Erişimini Ele Aldı